建站的时候就要规划 AI 大模型抓取适配吗?
建站的时候就要规划 AI 大模型抓取适配吗?很多企业在建站阶段,重心还停留在传统SEO排名、页面美观、本地流量转化上,容易忽略AI搜索的变化。随着AI大模型成为用户获取信息的重要入口,大模型抓取、内容引用、知识库提取已经和爬虫抓取逻辑深度绑定,到底要不要在建站初期就同步规划AI大模型抓取适配,已经是很多建站客户会问到的问题。
一、AI大模型抓取和传统搜索引擎爬虫,有什么不一样
传统搜索引擎爬虫核心目的是收录页面、提取关键词、计算页面权重,用于搜索结果页排序展示。而AI大模型抓取,除了读取页面文字,更偏向抽取结构化事实、观点、参数、服务信息,用来作为大模型回答用户问题的原始素材。
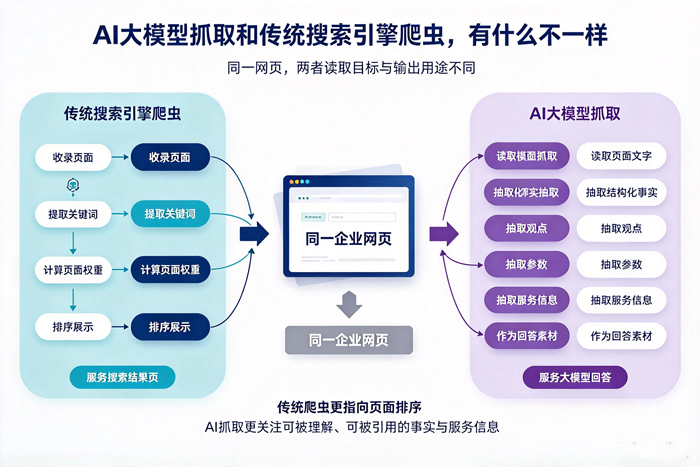
图:AI 大模型抓取 vs 传统搜索引擎爬虫
搜索引擎只要页面可访问、代码规范、内容可读,大多可以正常收录。但大模型对内容纯净度、信息边界、结构化标记、页面噪音容忍度更低。弹窗、大量无关广告、嵌套复杂JS渲染内容、错乱的标签层级,都会导致大模型提取信息混乱,出现答非所问、错误引用企业信息的情况。
二、为什么建议在建站阶段就做适配,而不是后期补改
等到网站上线之后再改造AI抓取适配,往往要改动底层架构,成本更高。模板建站最容易踩这个坑:模板自带大量冗余代码、无关模块、悬浮组件,建站完成之后再清理噪音、调整结构化数据、优化爬虫通道,相当于二次改版,还会伴随SEO波动风险。
在建站前期规划,可以从源头控制页面结构。合理规划robots规则、sitemap、Schema结构化数据、正文标签层级,区分主体内容和侧边栏、广告、导航等噪音区块,让大模型可以精准识别哪些是企业的有效业务信息,哪些是无关装饰内容。
三、AI抓取适配,建站阶段重点做好这几项
1. 基础可访问性优先保障
避免全部内容依靠纯前端JS渲染,大模型爬虫对JS渲染内容识别能力参差不齐。核心介绍、产品参数、服务范围、联系方式等业务正文,优先服务端直出,保证爬虫和大模型抓取器可以直接读取。同时做好服务器稳定性、页面加载速度,长时间超时打不开的页面,很难被大模型纳入素材库。
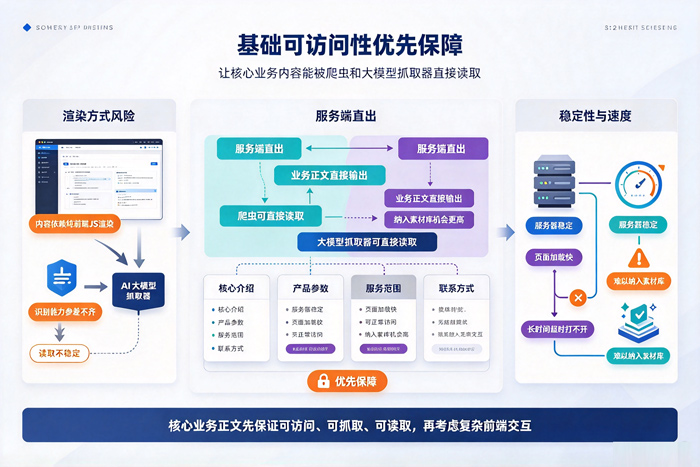
图:基础可访问性优先保障
2. 规范Schema结构化数据部署
LocalBusiness、Product、Article这类常用Schema,在建站的时候就预留输出位置,不要上线后手动零散添加。结构化数据相当于给大模型的信息说明书,明确标注企业地址、服务项目、产品规格、营业时间,提升信息被准确引用的概率,尤其适合本地服务类企业。
3. 控制页面噪音,明确内容边界
减少页面内频繁弹出的咨询弹窗、自动播放组件、大量无关推荐内容。H标签层级清晰,h1唯一,h2、h3顺着内容逻辑排布,不要滥用标题标签用来做样式美化。干净的内容结构,能够降低大模型混淆信息的概率。
4. 做好抓取权限管控
在robots.txt里面区分开放抓取和禁止抓取的目录,后台、表单提交页、重复列表分页、隐私页面可以限制抓取。不是所有页面都适合给大模型读取,提前规划抓取范围,可以避免内部测试内容、草稿信息被大模型抓取并对外输出。
四、是不是所有网站,都需要高标准AI抓取适配?
单纯只做老客户展示、不依赖线上搜索获客的官网,可以只维持基础规范,不用投入过多成本深度适配。但依靠搜索流量、本地询盘、产品线上引流的企业站,提前布局适配收益明显。AI搜索时代,用户很多问题不再点开搜索列表,直接由大模型整合信息给出答案,如果你的网站信息无法被准确抓取,就会丢失这部分新增流量入口。
五、总结
AI大模型抓取适配,不是独立于SEO之外的新技术,而是建站底层规范的延伸。最优方案就是在建站规划阶段同步纳入,和传统SEO、GEO本地布局一起设计,不用等网站上线之后再返工改造。干净的代码、清晰的结构、规范的结构化标记,既能适配搜索引擎,也能适配AI大模型抓取,一举兼顾两种流量渠道。